




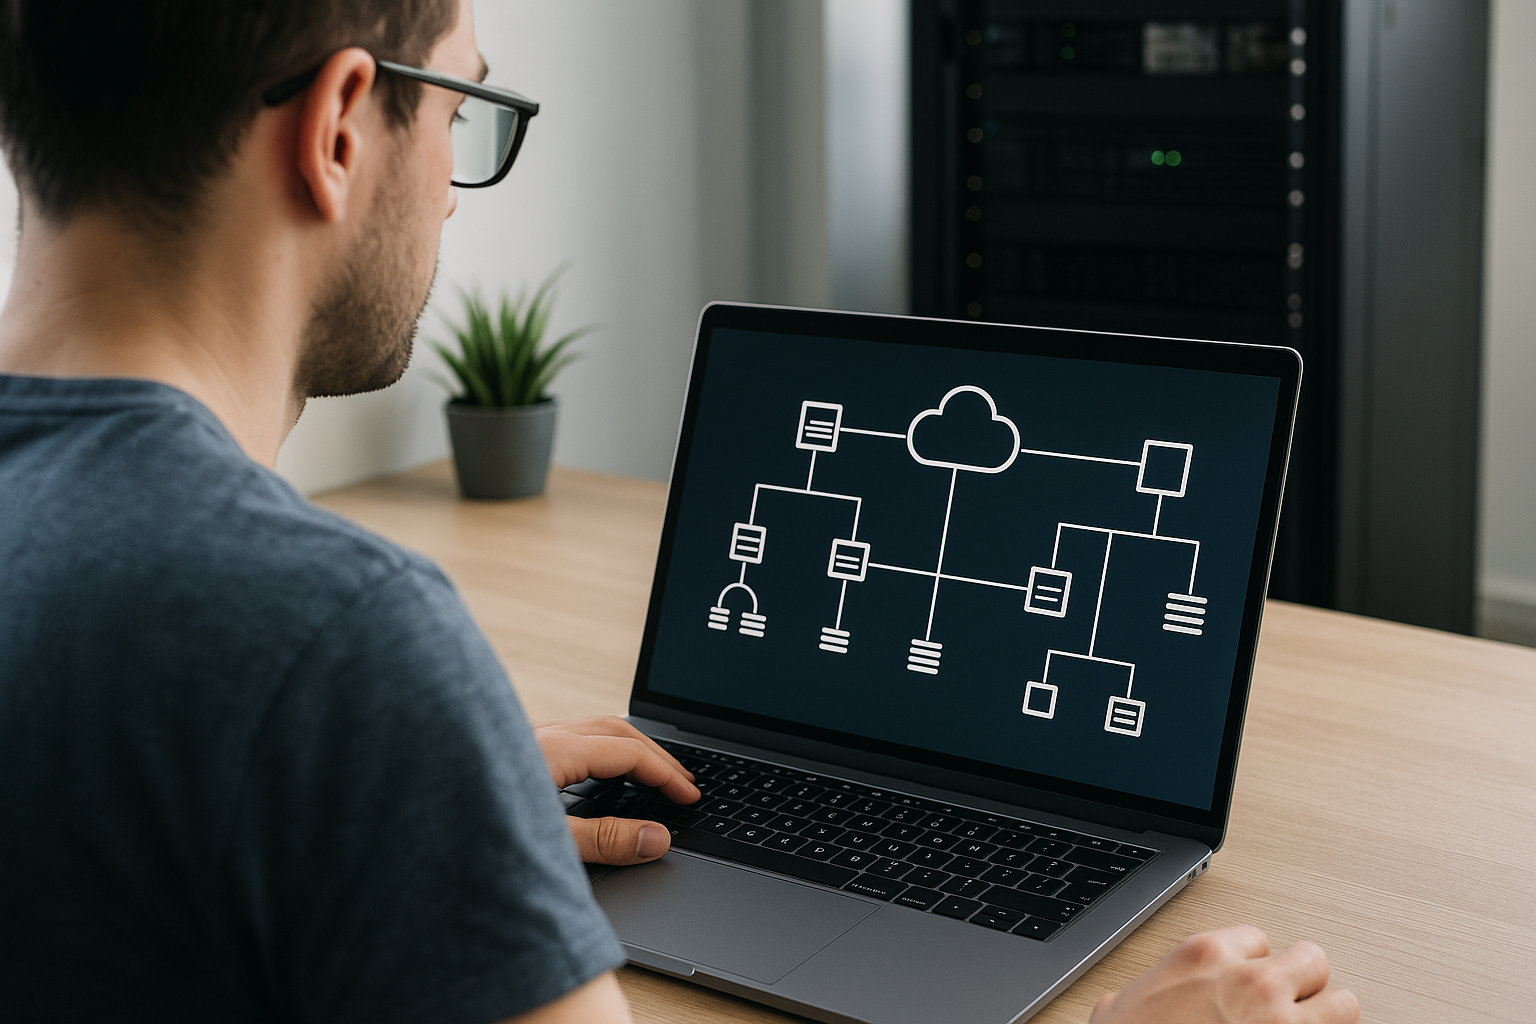
Perché l’elaborazione “vicino alla fonte” sta diventando la norma
L’edge computing è un modello in cui l’elaborazione avviene il più possibile vicino a dove i dati nascono: sensori, dispositivi, gateway, micro-datacenter locali. In pratica, invece di spedire tutto a un datacenter centrale, una parte del lavoro viene eseguita “ai margini” della rete. La definizione è semplice, ma l’impatto è enorme: meno tempo perso in trasmissione, meno dipendenza dalla connettività perfetta, più controllo su ciò che esce davvero dalla rete locale. Il punto non è “sostituire” il cloud, bensì ridisegnare il percorso dei dati: il cloud resta centrale per archiviazione, coordinamento e analisi a lungo termine, mentre l’edge gestisce ciò che richiede reazione immediata o filtraggio intelligente. Questo cambio di mentalità è spinto da un mix di fattori: crescita di dispositivi connessi, costi di banda, esigenze di privacy e un numero crescente di applicazioni che non tollerano ritardi percepibili.
Latenza, banda e resilienza: i tre motivi che contano davvero
Il primo vantaggio è la latenza, cioè il tempo che intercorre tra richiesta e risposta. Se un sistema deve reagire in millisecondi, inviare dati lontano e attendere una risposta può essere troppo lento o instabile. Il secondo è la riduzione del traffico: molti flussi sono rumorosi, ridondanti o inutili se presi “grezzi”. All’edge si può fare pre-processing (pulizia, aggregazione, compressione) e spedire in rete solo ciò che serve davvero. Il terzo è la resilienza: in caso di connessione intermittente, un nodo edge può continuare a funzionare localmente e sincronizzare più tardi. Qui entra in gioco un concetto chiave: decentralizzazione non significa caos, ma distribuzione controllata delle responsabilità. Un esempio concreto: un impianto industriale può rilevare vibrazioni anomale e fermare una linea in locale, senza aspettare un responso remoto; al cloud arriveranno log e trend, utili per analisi e manutenzione predittiva.
Architettura tipica: dispositivi, gateway, micro-datacenter e cloud
In un’architettura edge “classica” ci sono più livelli. Alla base ci sono i dispositivi (sensori, telecamere, macchine) che generano dati. Subito sopra spesso compare un gateway, cioè un nodo che raccoglie, normalizza e instrada i flussi, traducendo protocolli e applicando prime regole. Più in alto possono esserci piccoli cluster locali o micro-datacenter capaci di eseguire container e modelli di analisi. Il cloud rimane lo strato di coordinamento: distribuisce configurazioni, conserva dataset storici, esegue training pesanti e produce report. In questo scenario, “dove gira cosa” diventa una decisione progettuale: un modello di riconoscimento può eseguire l’inferenza in locale, mentre l’addestramento resta remoto. La regola pratica è: ciò che è time-critical e frequente tende a stare all’edge; ciò che è pesante, raro o globale tende a stare nel cloud. Per un quadro generale sui concetti di rete e instradamento, una risorsa autorevole è la guida introduttiva su standard e documenti tecnici di rete.
AI all’edge: inferenza locale, privacy e costi sotto controllo
Quando si parla di edge oggi, quasi sempre si finisce sull’inferenza di modelli di intelligenza artificiale: far girare un modello già addestrato direttamente dove serve, senza inviare continuamente immagini, audio o telemetrie complete. Questo porta due benefici immediati. Primo: privacy, perché si può evitare di trasferire dati sensibili o identificativi; spesso basta inviare eventi, conteggi o anomalie. Secondo: efficienza, perché la rete non si intasa e i costi di trasmissione si riducono. Un caso tipico è la visione artificiale: invece di inviare un flusso video continuo, un nodo edge può estrarre metadati (numero di passaggi, rilevamento di oggetti, soglie di sicurezza) e conservare solo clip rilevanti. Naturalmente c’è un rovescio della medaglia: l’hardware locale deve essere dimensionato, aggiornato e protetto; inoltre i modelli devono essere ottimizzati per girare su risorse limitate, con tecniche di quantizzazione e riduzione della complessità.
Sicurezza e governance: più nodi, più superficie d’attacco
Distribuire calcolo significa distribuire anche rischi. Ogni nodo edge è un potenziale punto d’accesso, perciò servono pratiche solide di hardening, gestione identità e aggiornamenti. La sicurezza non è solo “mettere una password”: include avvio verificato, cifratura dei dati a riposo e in transito, segmentazione di rete e logging consistente. Sul piano operativo, la sfida è la governance: mantenere coerenti configurazioni e policy su centinaia o migliaia di nodi. Qui diventano cruciali l’orchestrazione e la gestione centralizzata delle versioni software, con rollout graduali e possibilità di rollback. Anche la compliance conta: se i dati non possono lasciare un perimetro, l’edge diventa un alleato, ma solo se i processi sono documentati e verificabili. In altre parole, l’edge non “risolve” automaticamente la sicurezza: la sposta più vicino ai dispositivi, dove serve disciplina ingegneristica.
Dove sta andando: reti più intelligenti e applicazioni più reattive
La direzione è chiara: più applicazioni richiederanno decisioni rapide e locali, mentre il cloud si concentrerà su coordinamento, analisi su larga scala e ottimizzazione. Questo abilita scenari interessanti anche fuori dall’industria: esperienze interattive in tempo reale, monitoraggi ambientali capillari, servizi digitali che restano operativi anche con connettività ballerina. La parte “geek” è che stiamo tornando, in un certo senso, a un’idea di calcolo distribuito, ma con strumenti moderni: container leggeri, pipeline di dati, modelli AI compatti e automazione. La differenza rispetto al passato è la maturità delle pratiche: si progetta pensando a osservabilità, aggiornamenti continui e separazione tra dati grezzi ed eventi significativi. Chi pianifica oggi un sistema con dispositivi connessi farebbe bene a considerare l’edge non come un optional, ma come un livello architetturale: un posto preciso dove decidere cosa elaborare, cosa scartare e cosa inviare, mantenendo l’esperienza finale più rapida e affidabile.
Le informazioni fornite hanno scopo informativo e possono variare in base a contesto, requisiti e normative; per decisioni progettuali o di sicurezza è consigliabile una valutazione tecnica specifica.