




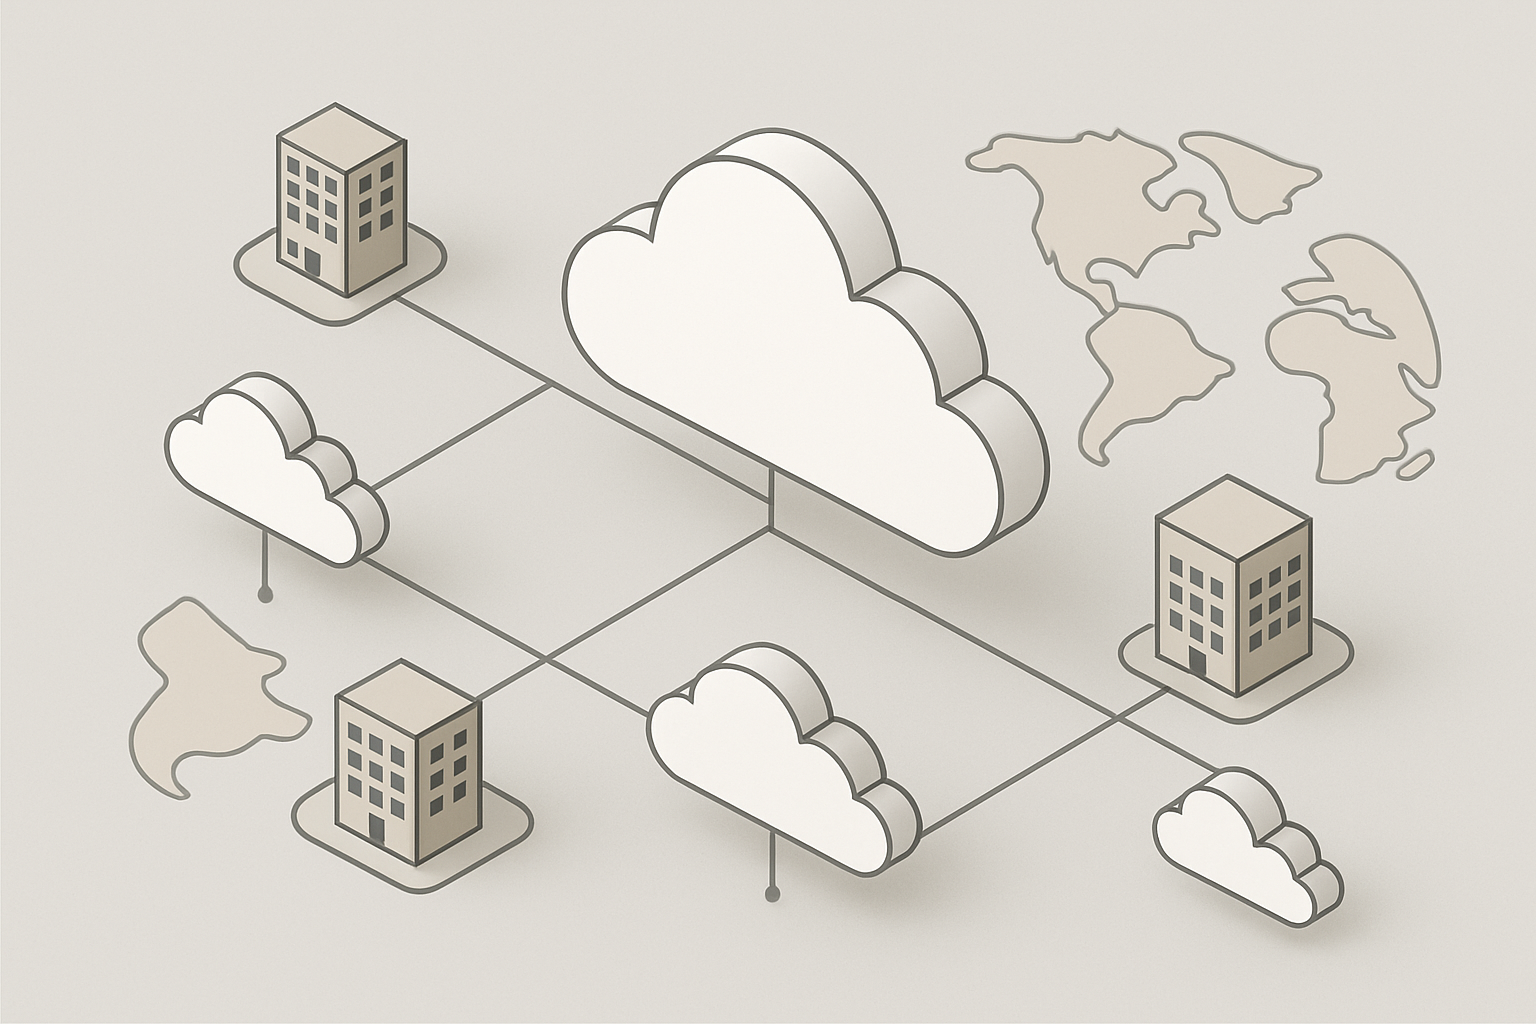
Che cos’è il cloud distribuito (definizione chiara) e perché conta adesso
Il cloud distribuito è un modello in cui servizi e risorse cloud (calcolo, storage, database, funzioni) vengono eseguiti in più sedi fisiche e geografiche, ma restano gestiti in modo coerente come un unico insieme. La differenza rispetto al cloud “classico” sta nel fatto che l’elaborazione non vive solo in pochi grandi data center centralizzati: viene portata più vicino a dove si trovano utenti, sensori, filiali e sistemi industriali. In pratica, l’azienda può usare la stessa piattaforma per distribuire carichi di lavoro tra regioni diverse, sedi locali e punti periferici, mantenendo policy, aggiornamenti e controllo centralizzati.
Questo approccio sta prendendo piede perché molte applicazioni moderne soffrono di latenza (ritardo nella risposta) e perché la normativa spinge verso la sovranità del dato: alcuni dati devono restare entro confini specifici o in ambienti controllati. Anche la crescita di dispositivi connessi e flussi in tempo reale rende più sensato elaborare vicino alla fonte, invece di spedire tutto a un unico centro.
Architettura: come si combinano edge, regioni e data center locali
Il cloud distribuito si appoggia a un’architettura a “strati”. All’esterno c’è l’edge computing, cioè l’elaborazione vicino a dispositivi e utenti (negozi, fabbriche, campus, piccoli nodi). Più all’interno ci sono regioni cloud geografiche, dove si concentrano servizi gestiti e capacità elastica. In mezzo possono esserci data center locali o ambienti dedicati, utili quando servono vincoli rigidi su rete e dati.
Per evitare che la distribuzione diventi caos, entrano in gioco concetti come orchestrazione (coordinare dove gira cosa), osservabilità (misurare log, metriche e tracce per capire cosa succede) e policy-as-code (regole di sicurezza e conformità espresse come codice). Dal punto di vista operativo, l’obiettivo è avere un’unica “regia” che governa aggiornamenti, configurazioni e accessi, pur distribuendo l’esecuzione.
Dato vicino al lavoro: caching, replica e consistenza
Quando i servizi sono sparsi, la gestione del dato diventa la parte delicata. Si usano spesso cache locali, repliche e code di messaggi per assorbire ritardi di rete. Qui entra un compromesso: la consistenza (tutti vedono subito lo stesso dato) contro la disponibilità e la velocità. In molte soluzioni distribuite si accetta una “consistenza eventuale” su alcune informazioni non critiche, mantenendo invece transazioni forti dove serve (pagamenti, inventari, identità).
Vantaggi concreti per le aziende: latenza, resilienza, conformità
Il beneficio più evidente è la riduzione della latenza, che rende più reattive applicazioni come assistenza in tempo reale, analisi di flussi industriali o esperienze interattive. Il secondo vantaggio è la resilienza: se una regione ha problemi, parte dei servizi può continuare a funzionare altrove, con strategie di failover e degrado controllato.
Sul fronte normativo, il cloud distribuito aiuta a rispettare requisiti di compliance e localizzazione, mantenendo dati sensibili in ambienti definiti. Inoltre può ridurre costi indiretti: meno traffico verso un centro lontano, meno tempi morti e più continuità operativa.
Un esempio pratico: una catena con molte sedi può elaborare localmente i dati di cassa e inventario per garantire operatività anche con connettività instabile, sincronizzando poi verso la piattaforma centrale. In questo modo l’esperienza non collassa se la rete “balla”, e i report restano coerenti.
Impatto sugli sviluppatori: nuove responsabilità e pattern di progettazione
Per chi sviluppa, il cloud distribuito non è solo “mettere copie in più posti”. Cambiano i pattern architetturali: più microservizi e componenti event-driven, più attenzione a timeout, retry e idempotenza (ripetere una richiesta senza effetti collaterali). Anche il testing si complica: bisogna simulare guasti di rete, ritardi e partizioni, perché in ambienti distribuiti non sono eccezioni rare ma condizioni normali.
Diventa centrale la gestione della sicurezza end-to-end: identità dei servizi, segreti, cifratura in transito e a riposo, segmentazione di rete. E cresce il peso della telemetria: senza una buona osservabilità, la diagnosi dei problemi diventa una caccia al tesoro.
Per orientarsi, è utile ragionare in termini di pochi principi pratici:
– progettare per il fallimento (retry controllati, circuit breaker, code)
– definire chiaramente dove risiede ogni dato e chi lo può leggere
– automatizzare rilasci e policy per evitare configurazioni “a mano”
Per una panoramica tecnica sui concetti di edge e distribuzione, una base solida è la documentazione introduttiva del National Institute of Standards and Technology: risorse NIST su cloud ed edge.
Rischi e compromessi: complessità, costi nascosti, governance
Il cloud distribuito porta vantaggi, ma introduce complessità organizzativa. La governance deve essere chiara: chi decide dove gira un servizio? chi approva una replica di dati? chi gestisce incidenti che coinvolgono più sedi? Senza regole, si finisce con un mosaico di eccezioni.
Ci sono anche costi meno visibili: più ambienti da monitorare, più superfici di attacco, più variabili di rete. E la distribuzione può aumentare la spesa se si duplicano risorse senza un piano. Serve un approccio misurabile: definire SLO (obiettivi di affidabilità), stimare il costo della latenza, e scegliere dove la distribuzione crea valore reale.
Il punto di svolta è trattare la piattaforma come un prodotto interno: standard, template, controlli automatici e percorsi chiari per i team. Quando questo manca, il cloud distribuito diventa un “moltiplicatore” di problemi; quando c’è, diventa un acceleratore di innovazione.
Le informazioni fornite hanno scopo informativo e possono richiedere adattamenti in base a normative, vincoli di sicurezza e architetture specifiche del contesto operativo.